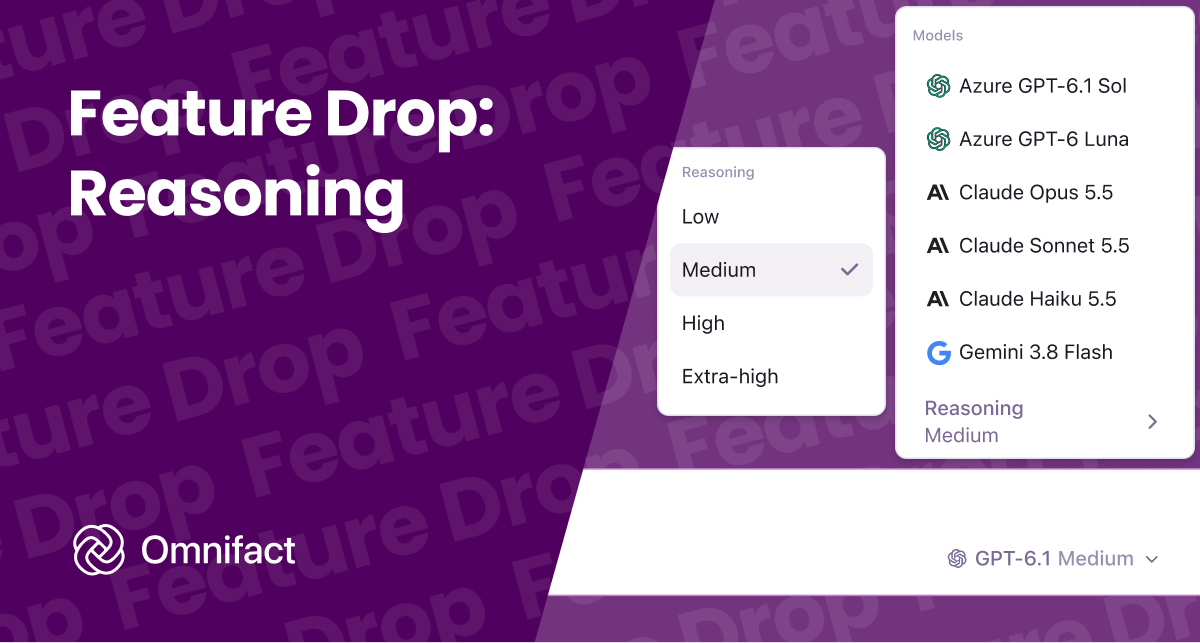
Wählen Sie direkt in der Modellauswahl des Chat Input zwischen Niedrig, Mittel, Hoch und Extra hoch.
Feature Drop: Reasoning
Published on October 8th, 2026
Nicht jede Aufgabe erfordert die gleiche Denktiefe. Eine kurze Übersetzung oder eine einfache Zusammenfassung profitiert von einer sofortigen Antwort, während eine detaillierte Vertragsprüfung oder eine technische Fragestellung sorgfältiges Abwägen verlangt.
Ab heute führt Omnifact anpassbares Reasoning für unterstützte Modelle in Omnifact ein. Sie können ab sofort festlegen, wie intensiv Modelle vor der Antwort nachdenken, und so Geschwindigkeit und Tiefe gezielt steuern.
Die passende Denktiefe für jede Aufgabe
Bei Modellen mit Reasoning-Unterstützung wie OpenAI GPT-6, Google Gemini 2.5 und 3 oder Claude Haiku 5.5 können Sie die Stufe flexibel anpassen:
- Niedrig: Minimale Denkzeit für schnelle Ergebnisse. Ideal für erste Entwürfe, Formatierungen, Übersetzungen und alltägliche Aufgaben, bei denen Geschwindigkeit zählt.
- Mittel: Ein ausgewogener Standard für strukturierte, verlässliche Antworten ohne spürbare Wartezeiten.
- Hoch und Extra hoch: Gibt dem Modell Raum für mehrstufige Logik, genaue Detailprüfungen und anspruchsvolle Fragestellungen. Perfekt für technische Analysen, Berechnungen und Richtlinienprüfungen.
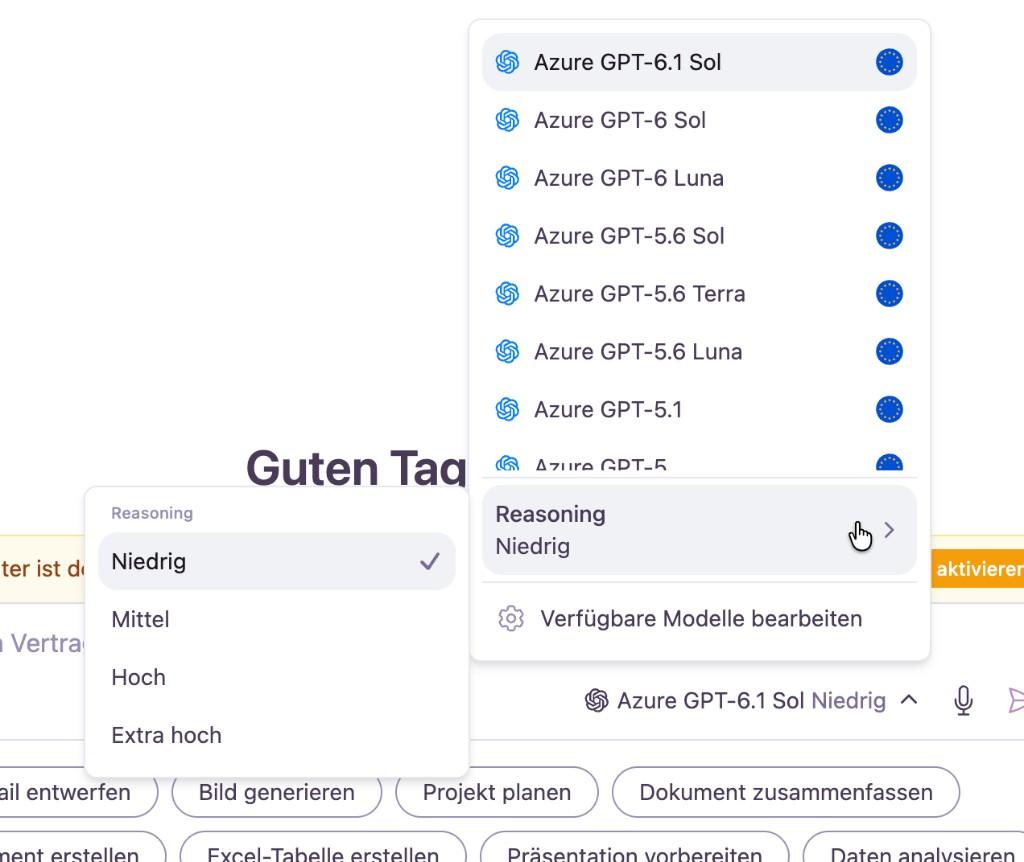
Direkt in der Modellauswahl
Die Reasoning-Steuerung befindet sich direkt in der Modellauswahl des Chat Input, genau dort, wo Sie Ihre Nachricht verfassen.
Sobald Sie ein Modell wählen, das Reasoning unterstützt, erscheint ein neuer Menüpunkt Reasoning mit den verfügbaren Stufen des jeweiligen Modells. Der Button im Chat Input zeigt die aktive Stufe direkt neben dem Modellnamen an, sodass Sie Ihre Einstellung stets im Blick behalten.
Omnifact merkt sich Ihre Auswahl für jedes Modell. So können Sie ein schnelles Modell wie Claude Haiku 5.5 auf Niedrig für Routineaufgaben belassen, während Sie Claude Opus 5.5 für tiefgehende Analysen auf Hoch oder Extra hoch setzen. Egal welche Stufe Sie wählen: Wenn aktiviert, wird jede Eingabe, jedes abgerufene Dokument und jeder interne Denkschritt durch unseren Privacy Filter geschützt, bevor Daten externe Modelle erreichen.
Ab heute verfügbar
Reasoning steht ab sofort allen Organisationen auf Omnifact zur Verfügung. Starten Sie eine neue Unterhaltung, wählen Sie ein Modell mit Reasoning im Chat Input und testen Sie die neuen Optionen in Ihren täglichen Arbeitsabläufen.